
Ollama konfigurieren
Vor der Verbindung
Auf dem Modellserver muss Ollama installiert sein, das gewünschte Modell muss heruntergeladen und der Dienst gestartet sein. Ein Administrationsbeispiel:ollama list, welche Modelle bereitstehen. Der Server muss von der Novaplan-AI-Umgebung aus erreichbar sein; ein Dienst, der nur auf localhost des Modellservers lauscht, ist von einem anderen Host nicht automatisch erreichbar.
Angaben in Novaplan AI
Ollama verwendet standardmäßig Port
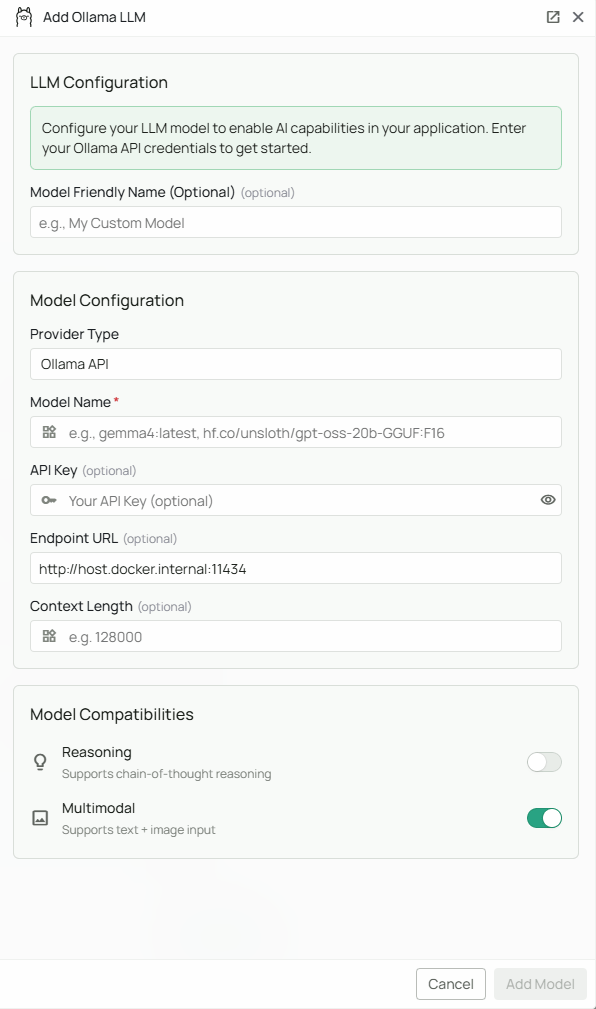
11434. host.docker.internal ist nur dann ein geeignetes Ziel, wenn dieser Name aus dem verwalteten Workspace auf den richtigen Modellserver zeigt. localhost auf Ihrem eigenen Computer ist von dort nicht automatisch erreichbar. Lassen Sie die tatsächliche Endpoint-Adresse von Novaplan prüfen.
Modell hinzufügen
- Klicken Sie auf der Ollama-Anbieterkarte auf Configure.
- Geben Sie den Model Name ein und passen Sie bei Bedarf Endpoint URL und API Key an.
- Setzen Sie Multimodal und Reasoning nur passend zu den Fähigkeiten des Modells.
- Klicken Sie auf Add Model.
ollama list auf dem Modellserver, ob die exakte Modell-ID geladen ist. Bei Speichermangel oder langsamer Antwort helfen gegebenenfalls ein kleineres oder quantisiertes Modell beziehungsweise ein geeigneter GPU-Server. Ein selbst betriebener Ollama-Server hat keine nutzungsabhängige lokale API-Gebühr; Rechenleistung, Speicher, Netzwerk, Novaplan-Dienst und gegebenenfalls ein gehosteter Anbieter können dennoch Kosten oder Limits verursachen. Weitere Informationen bietet die Ollama-Dokumentation; Novaplan Support hilft bei der Anbindung.