
- Einer Weboberfläche für Suche, Chat und Administration im Browser.
- Einer API, die Nutzende authentifiziert, Berechtigungen durchsetzt und Wissensdatenbanken sowie Dateien verwaltet.
- Python-Diensten, die Daten aus Unternehmensanwendungen synchronisieren, Dokumente durchsuchbar machen und Antworten mit Quellenangaben zurückgeben.
Weg einer Anfrage durch das System
1
Sie fragen im Browser, über eine API oder über einen Agenten
Die Weboberfläche, ein REST- oder SDK-Client beziehungsweise ein MCP-Client sendet Ihre Frage über HTTP an die Node.js-API. Chat und Suche können Antworten über Server-Sent Events (SSE) streamen. Dabei bleibt die Verbindung offen, sodass die Antwort während ihrer Erstellung erscheint.
2
Die API prüft Ihre Identität
Die Node.js-API prüft Ihre Sitzung oder Ihr Token, wendet Ihre Berechtigungen an und leitet die Frage an den Query-Dienst weiter.
3
Query findet Quellen und formuliert eine belegte Antwort
Query sucht zusammengehörige Datensätze im Wissensgraphen und ähnliche Textstellen im konfigurierten Vektorspeicher (Qdrant in der Referenzarchitektur). Anschließend ruft der Dienst das Sprachmodell des Workspaces auf. Die Antwort enthält Quellenangaben, die auf die ursprünglichen Dokumente verweisen.
- Konnektoren holen Daten aus Slack, Drive, Jira, Confluence und weiteren Quellen.
- Sie veröffentlichen neue oder geänderte Datensätze auf dem Event-Bus.
- Indexing verarbeitet die Dateien, wandelt Text in Vektoren um und schreibt in den Wissensgraphen und den konfigurierten Vektorspeicher.
Architekturdiagramm
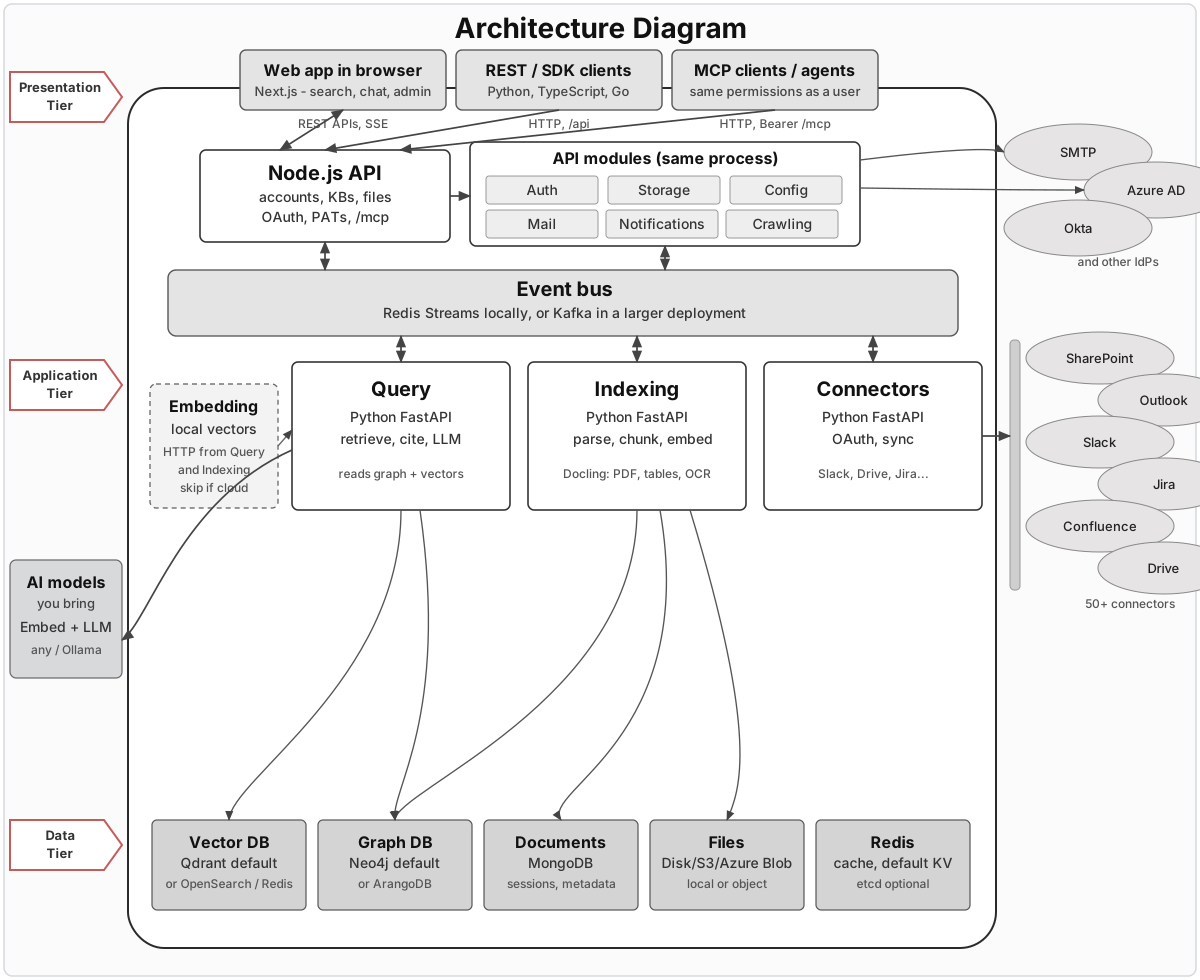
Klicken Sie auf die Abbildung, um sie in voller Größe zu öffnen.
Zugriffswege auf Novaplan AI
Weboberfläche
Nutzende greifen im Browser auf Novaplan AI zu. Die Next.js-Anwendung bietet Suche, Chat und Administration.REST- und SDK-Clients
Eigene Anwendungen können freigegebene HTTP-Schnittstellen verwenden. Der Leitfaden zum API-Zugang hilft bei der Wahl eines Integrationswegs. Fragen Sie Novaplan Support, welche Routen, SDK-Optionen und Berechtigungen für Ihren Workspace unterstützt werden.Agenten und MCP
Agenten verbinden sich über Streamable HTTP mit/mcp. Die Einrichtung beschreibt der MCP-Überblick. Ein Agent meldet sich mit einem persönlichen Zugriffstoken an und erhält dieselben Datensätze, die die zugehörige Person nach eigener Anmeldung sehen würde.
Node.js-API
Die API ist ein mit Express erstellter Node.js-Prozess. Weboberfläche, REST- und SDK-Clients sowie MCP-Clients kommunizieren mit diesem Prozess. Er verwaltet Konten, Berechtigungen, Wissensdatenbanken, Datei-Uploads, Authentifizierung, persönliche Zugriffstoken und MCP. Novaplan betreibt die Laufzeitumgebung und stellt Weboberfläche, API und MCP-Endpunkt unter der freigegebenen Workspace-Adresse bereit. Kunden benötigen keine lokalen Dienst-Ports, um diese Schnittstellen zu verwenden. Für Aufgaben im Workspace helfen die Anleitungen zu Benutzern, Konnektoren und MCP. Der detaillierte Katalog der Dienst-APIs bleibt zurückgestellt, bis die Schnittstellen der bereitgestellten Enterprise-Version geprüft sind.Verarbeitung im Hintergrund
Module im API-Prozess
Auth, Storage, Mail, Config, Notifications, Crawling und der Connector Manager laufen innerhalb desselben Express-Prozesses.Event-Bus
Konnektoren veröffentlichen Datensätze auf dem Event-Bus; Indexing verarbeitet sie. Novaplan wählt den Transport für die verwaltete Umgebung:- Redis Streams kann Konnektor-Ereignisse an Indexing übergeben.
- Kafka ist eine alternative Ereignisplattform für größere Umgebungen.
Query, Indexing und Connectors
Query, Indexing und Connectors sind Python-FastAPI-Dienste. Connectors kommuniziert mit Slack, Drive, Jira, Confluence und weiteren Unternehmensanwendungen. Der Dienst schließt OAuth-Vorgänge mit den jeweiligen Anbietern ab, erneuert Token und veröffentlicht neue oder geänderte Datensätze auf dem Event-Bus. Der Connector Manager in der API speichert die verschlüsselte Konfiguration und leitet OAuth-Weiterleitungen des Browsers an diesen Python-Dienst weiter. Der Konnektoren-Überblick enthält die Liste der dokumentierten Quellen. Indexing übernimmt diese Datensätze vom Event-Bus. Es verarbeitet Dateien, teilt sie in Abschnitte, erzeugt Texteinbettungen und schreibt in Vektorspeicher und Wissensgraph. Docling ist der aufwendigere Parser für PDFs, Tabellen und OCR. Je nach verwalteter Konfiguration können zusätzlich separate Parsing- und Extraction-Dienste eingesetzt werden. Query beantwortet Fragen. Der Dienst liest Wissensgraph und Vektorspeicher und ruft dann das Sprachmodell auf. Über den Event-Bus erhält er auch Konfigurationsänderungen.Embedding-Server
Indexing und Query benötigen Vektoren: Zahlenfolgen, die die Bedeutung eines Textabschnitts repräsentieren. So lassen sich später ähnliche Passagen finden. Die verwaltete Umgebung kann einen eigenen Embedding-Server mit der OpenAI-kompatiblen API/v1/embeddings oder einen konfigurierten Cloud-Anbieter verwenden. Der Kasten ist im Diagramm gestrichelt, weil Query und Indexing diesen Dienst bei Verwendung direkt über HTTP aufrufen.
Datenspeicher
Jeder Kasten am unteren Rand des Diagramms hält einen anderen Zustandstyp. Die Tabelle zeigt die Technologien der Referenzarchitektur; die tatsächliche Novaplan-Umgebung kann einen anderen unterstützten Backend-Dienst verwenden. Hinweise zu den Anbietern stehen unter Externe Dienste.Eingebundene Modelle
Novaplan AI wird mit Modellen verbunden, die Sie bereits verwenden.- Ein Embedding-Modell wandelt verarbeiteten Text in Vektoren für den konfigurierten Vektorspeicher um. Die Referenzarchitektur kann einen lokalen Embedding-Server verwenden; ein verwalteter Workspace kann einen anderen Anbieter einsetzen.
- Ein Sprachmodell (LLM) formuliert die Antwort mit Quellenangaben. Sie können einen beliebigen Anbieter oder ein lokales Modell über Ollama verwenden.