
Whisper (lokal) konfigurieren
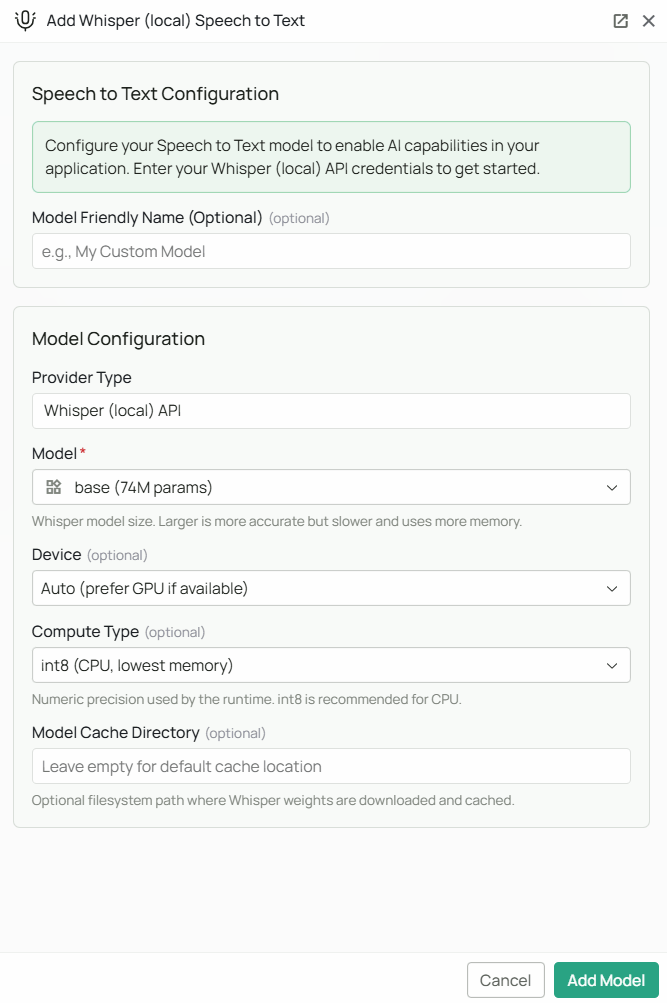
faster-whisper innerhalb der verwalteten Backend-Umgebung ausführen. „Lokal“ bezieht sich auf dieses Backend, nicht auf Ihren Computer. Für diese Option ist kein Schlüssel einer externen Transkriptions-API erforderlich. Das Audio wird vom Backend verarbeitet, statt zur Transkription an eine separate Speech-to-Text-API gesendet zu werden. Wenn Sie Anforderungen an den Speicher- oder Verarbeitungsort haben, klären Sie die Hosting- und Datenverarbeitungsvereinbarungen Ihres Workspaces mit Novaplan.
Beim ersten Einsatz werden Modellgewichte von Hugging Face heruntergeladen. Novaplan verwaltet dafür Netzwerkzugang, Paketinstallation, Speicher und Rechenkapazität des Backends. Wenden Sie sich an Novaplan Support, wenn die Modelleinrichtung oder der Health Check fehlschlägt.
Modell wählen
Model ist das einzige Pflichtfeld. Größere Modelle können genauer sein, benötigen aber mehr Arbeitsspeicher und Rechenzeit.
Wahl der Modellgröße:
- Wenn bei Spracheingaben in Echtzeit die Geschwindigkeit zählt, beginnen Sie mit
baseodersmall. - Für wichtige Aufnahmen mit hohen Genauigkeitsanforderungen prüfen Sie
distil-large-v3oderlarge-v3. - Größere Modelle können sinnvoll sein, wenn im verwalteten Workspace eine GPU bereitsteht. Lassen Sie die Kapazität von Novaplan bestätigen.
Optionale Einstellungen
Device
Legt fest, auf welcher Hardware das Modell läuft:- Auto (Standard) verwendet eine GPU, falls verfügbar, und sonst die CPU.
- CPU erzwingt die Verarbeitung auf dem Prozessor des Workspace-Backends.
- CUDA verwendet eine kompatible NVIDIA-GPU im Backend, sofern sie bereitgestellt wurde.
Compute Type
Steuert die numerische Genauigkeit während der Verarbeitung. Geringere Präzision kann Speicher sparen und die Ausführung beschleunigen; höhere Präzision benötigt mehr Ressourcen.Model Cache Directory
Dies ist ein Dateipfad im verwalteten Backend, unter dem heruntergeladene Modellgewichte gespeichert werden. Lassen Sie das Feld leer, um den Standard-Cache vonfaster-whisper zu verwenden. Ein benutzerdefinierter Pfad muss in der Workspace-Umgebung existieren und beschreibbar sein; stimmen Sie ihn vorher mit Novaplan ab.
Beispiel: /data/whisper-models. Novaplan kann einen eigenen Cache einrichten, wenn der Standardspeicherplatz knapp ist.
Konfiguration
Wie in der Abbildung gezeigt:- Klicken Sie im Tab STT bei Whisper (Local) auf Configure.
- Wählen Sie die gewünschte Model-Größe aus dem Pflichtfeld.
- Stellen Sie bei Bedarf Device ein; lassen Sie Auto ausgewählt, sofern Sie CPU oder GPU nicht gezielt festlegen möchten.
- Stellen Sie bei Bedarf Compute Type ein; für CPU ist
int8, für GPUint8_float16ein Ausgangspunkt. - Tragen Sie bei Bedarf ein Model Cache Directory ein.
- Vergeben Sie optional einen Model Friendly Name als Anzeigenamen.
- Klicken Sie auf Add Model, um die Konfiguration zu speichern.
Hinweise zum Betrieb
- Für diesen Anbieter fällt keine separate Gebühr einer externen Transkriptions-API an. Verwaltete Rechenleistung und Speicher bleiben Teil Ihrer Servicevereinbarung.
large-v3benötigt ungefähr 3 GB Speicherplatz und mindestens 4 GB VRAM oder für CPU-Verarbeitung etwa 8 GB RAM.distil-large-v3ist eine schnellere große Modellvariante. Prüfen Sie Genauigkeit und Latenz mit Ihren eigenen Aufnahmen, bevor Sie sie auswählen.- Der erste Einsatz erfordert den Download der Modellgewichte durch das verwaltete Backend. Spätere Transkriptionen benötigen keine externe Transkriptions-API; andere Workspace-Funktionen können weiterhin Netzwerkzugang erfordern.
- Whisper kann Sprache in mehr als 50 Sprachen automatisch transkribieren.
Fehlerbehebung
- Wenn der Health Check fehlschlägt oder Gewichte nicht heruntergeladen werden können, bitten Sie Novaplan, das Paket
faster-whisper, die Verbindung zuhuggingface.cound den Modell-Cache zu prüfen. - Wenn die Transkription zu langsam ist, wählen Sie ein kleineres Modell oder fragen Sie Novaplan nach GPU-Kapazität.
- Bei Speichermangel wählen Sie ein kleineres Modell oder den Compute Type
int8. Novaplan kann die Backend-Kapazität prüfen. - Bei einem benutzerdefinierten Model Cache Directory sollte Novaplan prüfen, ob der Pfad existiert und für den Workspace-Prozess beschreibbar ist.